插值法: 从节点数据到多项式与误差
知道一个函数在几个位置的值, 能不能估计它在其他位置的值? 插值法就在处理这件事. 最开始看这一章, 拉格朗日、牛顿、均差、差分很容易混在一起. 我把它们放到同一组小数据上算一遍, 再用 C++ 和几组实验看看各自的特点.
第一次读, 可以先跟着三个点的例子走. 余项的证明放在后面, 不影响先把程序跑起来.
1. 插值到底要做什么
1.1 已知几个点, 还缺点之间的值
假设目前只知道下面三个点:
| 0 | 1 | 2 | |
|---|---|---|---|
| 0 | 1 | 4 |
现在想求 时的值. 最容易想到的是连接相邻两个点. 在 和 之间画一条直线, 得到 .
也可以让一条抛物线经过三个点. 这次得到的是 , 所以 时, . 两种办法都经过给定的点, 在点之间却给出了不同的结果.
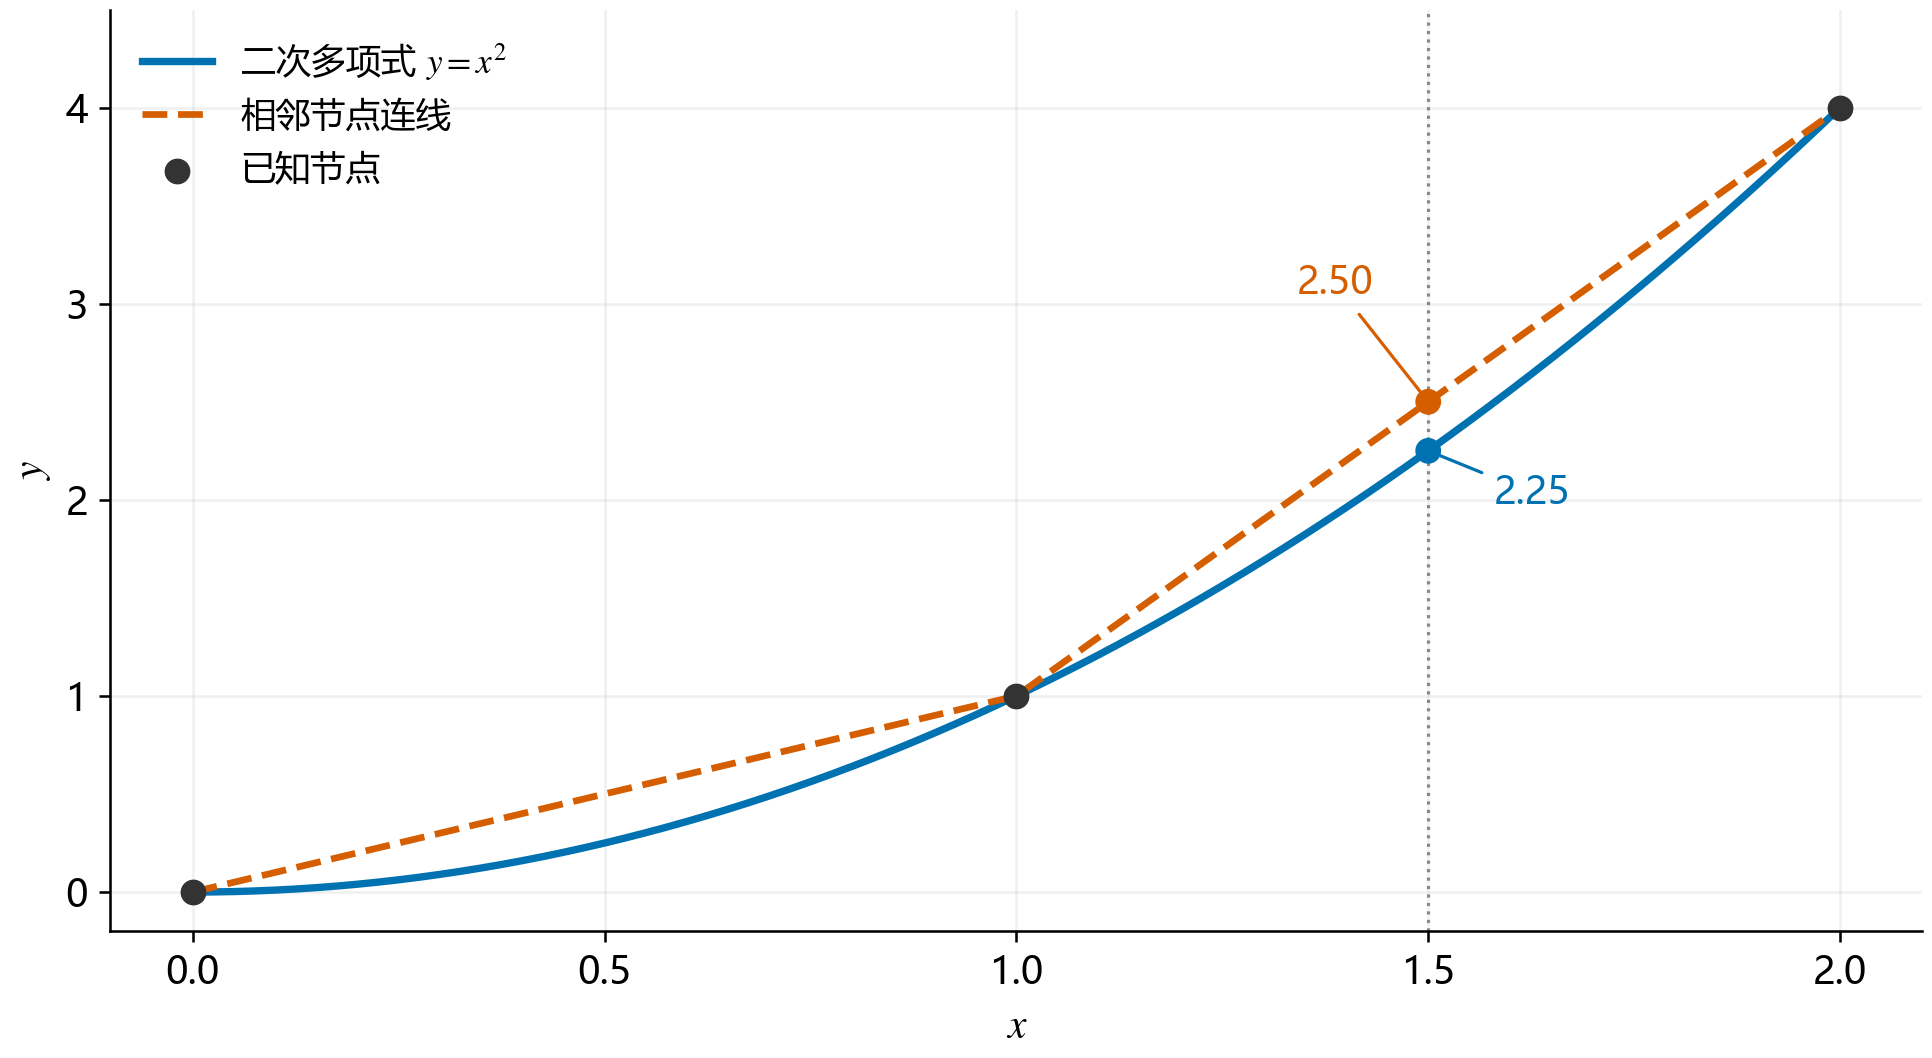
黑点是已经知道的数据, 蓝线和橙线都经过它们. 竖虚线对应要估计的位置 . 图上两种结果的差别, 来自我们选择了不同的插值函数.
这里先不说哪一个更好. 如果原函数是 , 第二个结果就是精确值; 如果只拿到一张测量表, 我们还需要考虑函数特点、节点分布和测量误差.
定义 | 插值 (Interpolation): 构造一个容易计算的函数 , 使它在每个已知节点上满足 , 再用它估计其他位置的函数值.
这一章主要用多项式做插值函数. 拟合也会处理一组数据, 但通常不要求曲线经过每一个点. 插值要求经过给定的点, 这个条件贯穿下面所有公式.
1.2 为什么说插值多项式是唯一的
先把条件说完整: 给定 个横坐标互不相同的点, 次数不超过 的插值多项式存在且唯一.
这里的 是次数上限. 三个点对应次数不超过 2, 但如果三个点恰好共线, 最后得到的就只是一条直线.
唯一性可以这样理解. 假设 和 都满足条件, 那么 的次数不超过 , 却在这 个节点上都等于零. 一个非零的 次多项式最多有 个不同的根, 因此这个差只能是零, 两个多项式其实相同.
次数限制不能省. 给 加上 , 仍然经过原来的所有点, 但次数已经超出了限制.
这也解释了后面一个看着奇怪的现象: 范德蒙德、拉格朗日和牛顿的公式不同, 用同一组节点和同一个次数上限时, 它们算的却是同一个多项式.
2. 拉格朗日: 给每个节点安排一个基函数
2.1 先让一个点留下, 其他点消失
拉格朗日插值 (Lagrange Interpolation) 的想法很直接. 为第 个节点构造一个基函数 , 让它在自己的节点上等于 1, 在其他节点上等于 0:
怎样做出这些零点? 把其他节点对应的因子乘起来, 再除以它在 处的值:
代入 时, 只要 , 分子里就有一个因子为零. 代入 时, 每个分式都是 1. 所以把它们按节点函数值加起来就行:
2.2 用刚才的三个点算一次
对于 , 三个基函数是:
代入 , 得到 . 然后按 加权:
这些权重的和是 1, 但不一定都为正. 先记下这一点, 后面分析扰动时会用到.

基函数图可以检查三个节点上的 0、1 条件, 权重图就是刚才代入 后得到的三个权重. 下面代码里的 t 依次计算这三个数, ans 再把它们乘上对应的 y[i] 后累加.
2.3 一个可以直接运行的 C++ 例子
代码中的 count 表示节点个数, 所以本例 count=3, 对应公式里的 . z 是待求值的位置.
#include <iostream>
#include <iomanip>
using namespace std;

double lagrange(double x[], double y[], int count, double z) {
    double ans = 0;
    for (int i = 0; i < count; i++) {
        double t = 1;
        for (int j = 0; j < count; j++) {
            if (j != i)
                t *= (z - x[j]) / (x[i] - x[j]);
        }
        ans += y[i] * t;
    }
    return ans;
}

int main() {
    double x[] = {0, 1, 2};
    double y[] = {0, 1, 4};
    cout << fixed << setprecision(6);
    cout << lagrange(x, y, 3, 1.5) << '\n';
    return 0;
}
输出是 2.250000. 外层循环枚举节点, 内层循环计算这个节点的基函数, 最后累加 y[i] * t. 可以直接把这三步对应到上面的公式.
这份写法每求一个位置, 都需要两层循环, 计算量约为 . 它适合用来理解公式. 节点多、求值次数多时, 通常会考虑重心形式等其他实现.
3. 范德蒙德: 把未知系数解出来
3.1 先把多项式写成最熟悉的样子
如果直接设:
再把每个节点代入, 就得到关于 的线性方程组. 刚才的例子是:
解得 , 仍然是 .
这个系数矩阵叫范德蒙德矩阵 (Vandermonde Matrix). 一般情况下, 它的行列式为:
节点互不相同, 每个因子都不为零, 方程组就有唯一解. 这是教材证明插值多项式存在唯一的一种方式.
3.2 程序里分成三步
- 用节点构造增广矩阵. 每一行依次放 , 最后一列放
- 用高斯消元求系数. 在当前列中选绝对值最大的一行交换, 再消元、回代
- 用嵌套乘法求值, 避免逐个计算幂次
例如二次多项式可以写成 . 完整程序最后的求值部分就是:
double ans = c[count - 1];
for (int i = count - 2; i >= 0; i--)
    ans = ans * z + c[i];
其中 c 已经存放求出的系数. 后面的下载区有完整的消元代码.
这条路线便于理解, 但节点多时, 幂次列可能让矩阵变得病态. 小的数据误差和浮点运算误差都可能被放大. 选主元能改善消元过程, 却不能保证所有范德蒙德矩阵都算得很准.
4. 牛顿: 每增加一个点, 就补一项
4.1 新的一项不能破坏旧节点
牛顿插值 (Newton Interpolation) 从一个点开始:
增加第二个点时, 加一项 . 这样在 处, 新项为零, 原来的结果不受影响:
再增加第三个点, 就加 . 它在前两个节点上都为零. 按这个办法继续, 得到:
这里的 是均差 (Divided Difference), 也叫差商. 一阶均差就是两点之间的平均变化率:
高阶均差继续递推:
注意分母的下标: 它用的是这一组节点的首尾距离, 不是始终除以相邻节点的间距.
4.2 把均差表填出来
仍然用 :
| 节点 | 函数值 | 一阶均差 | 二阶均差 |
|---|---|---|---|
| 0 | 0 | ||
| 1 | 1 | ||
| 2 | 4 |
取表中第一行的系数, 得到:
所以拉格朗日和牛顿没有在这里产生两条不同的抛物线. 它们只是在用不同的形式写同一个结果.

蓝线是当前的多项式, 灰色点线是目标 . 黑点表示已经满足的节点, 空心点表示接下来要加入的节点. 从常数到直线, 再到抛物线, 新加的项在旧节点上都等于零, 因而旧节点不会被改坏.
4.3 均差表和求值代码
下面这些函数同样用 count 表示节点个数, 示例数组最多放 100 个节点. 节点需要互不相同; 分段函数还假设节点按横坐标递增排列, 求值位置在节点区间内.
double newton(double x[], double y[], int count, double z) {
    double d[100][100] = {};
    for (int i = 0; i < count; i++)
        d[i][0] = y[i];
    for (int k = 1; k < count; k++) {
        for (int i = 0; i < count - k; i++)
            d[i][k] = (d[i + 1][k - 1] - d[i][k - 1])
                    / (x[i + k] - x[i]);
    }
    double ans = d[0][count - 1];
    for (int i = count - 2; i >= 0; i--)
        ans = ans * (z - x[i]) + d[0][i];
    return ans;
}
d[i][k] 对应从 到 的 阶均差. 最后几行把牛顿多项式按嵌套形式计算. 对三个节点, 就是:
建表需要 的工作, 建好以后每次求值只需 . 本文的简单函数为了方便阅读, 每次调用都重新建表; 大量求值时可以把建表与求值分开.
4.4 等距节点时, 均差可以换成差分
如果 , 节点间距固定为 , 就能使用前向差分 (Forward Difference):
刚才的数据, 一阶差分是 1、3, 二阶差分是 2. 因为 , 有 .
一般的关系是:
可以用归纳法检查这个关系. 一阶时, 均差就是 . 若 阶时成立, 将两个相邻的 阶均差相减, 分子变成 , 再除以首尾距离 , 分母就变成 .
接着令 , 则:
把这两个关系代入牛顿公式, 正好抵消, 得到牛顿前插公式:
差分形式来自一般牛顿公式在等距节点下的化简. 节点不等距时, 应使用一般均差公式.
代码里不用分别计算阶乘和一长串乘积, 逐项递推它们的比值即可:
double forward(double x[], double y[], int count, double z) {
    double d[100][100] = {};
    for (int i = 0; i < count; i++)
        d[i][0] = y[i];
    for (int k = 1; k < count; k++) {
        for (int i = 0; i < count - k; i++)
            d[i][k] = d[i + 1][k - 1] - d[i][k - 1];
    }
    double t = (z - x[0]) / (x[1] - x[0]);
    double ans = y[0], p = 1;
    for (int k = 1; k < count; k++) {
        p *= (t - k + 1) / k;
        ans += p * d[0][k];
    }
    return ans;
}
这里 p 依次变成 , , . 如果想检查循环, 可以先把每次的 p 和 d[0][k] 打印出来, 再和手算表对照.
5. 分段插值: 只处理眼前这一小段
5.1 分段线性, 就是相邻两点连线
前面的方法用所有节点构造一个多项式. 分段线性插值 (Piecewise Linear Interpolation) 只看求值位置左右的两个点.
设 , 令 , 则:
区间内 , 两个权重非负, 而且相加为 1. 这正是最开始在 处算出 2.5 的办法.
double linear(double x[], double y[], int count, double z) {
    int i = 0;
    while (i < count - 2 && z > x[i + 1])
        i++;
    double t = (z - x[i]) / (x[i + 1] - x[i]);
    return (1 - t) * y[i] + t * y[i + 1];
}
循环先找到小区间, 然后代入两点公式. 曲线在节点处连续, 但左右两段的斜率通常不同, 所以会出现折角.
5.2 Hermite, 再加上两端的斜率
两点三次 Hermite 插值 (Cubic Hermite Interpolation) 使用两个端点的函数值和一阶导数. 记 , 在每一段要求:
四个条件决定一个次数不超过 3 的多项式. 仍令 , , 可以写成:
为什么导数项前面有 ? 因为 是归一化后的变量, . 乘上 才能让端点处对 的导数与给定斜率一致.
double hermite(double x[], double y[], double s[], int count, double z) {
    int i = 0;
    while (i < count - 2 && z > x[i + 1])
        i++;
    double h = x[i + 1] - x[i];
    double t = (z - x[i]) / h;
    double h00 = 2 * t * t * t - 3 * t * t + 1;
    double h01 = -2 * t * t * t + 3 * t * t;
    double h10 = t * t * t - 2 * t * t + t;
    double h11 = t * t * t - t * t;
    return h00 * y[i] + h01 * y[i + 1]
         + h * h10 * s[i] + h * h11 * s[i + 1];
}
对于 , 导数是 . 在 上使用函数值 1、4 和斜率 2、4, 代入 会得到 2.25. 导数提供了额外信息, 让曲线知道该怎样进入和离开这一段.

线性插值的直线只用了两个函数值, Hermite 插值还使用绿色短线标出的斜率. 对这个二次函数, Hermite 曲线与目标完全重合. 代码中的 h00、h01 对应函数值的权重, h10、h11 则配合 h 和 s[i] 使用导数信息.
相邻区间使用同一个节点导数时, 分段 Hermite 的一阶导数也连续. 它一般不保证二阶导数连续; 三次样条则会进一步处理这类光滑条件, 本文先不展开.
6. 余项: 经过所有节点, 为什么还会有误差
6.1 先区分三种误差
讨论理论时, 节点值被看作精确数据, 计算也被看作精确运算. 真正写程序时, 还会遇到另外两件事:
| 情况 | 误差从哪里来 |
|---|---|
| 原函数与插值多项式不同 | 插值的截断误差 |
| 输入的节点函数值有偏差 | 数据误差及其传播 |
| 使用有限精度的浮点数运算 | 舍入误差 |
理论余项主要回答第一行. 它不能直接保证一份浮点程序的最终误差, 也不包含人为加入的随机扰动.
6.2 乘积的因子为什么比次数多一个
若 , 节点位于这个区间内, 对区间内的求值位置 , 多项式插值余项可以写成:
这里用了一个便于记忆的充分光滑条件. 在节点和求值位置所确定的区间内, 通常随 变化, 并不是一个能直接从输入读出来的固定值.
乘积在每个节点上都会归零, 这符合插值误差在节点处为零的要求. 但只有这一点, 还不能确定前面的系数. 系数要靠罗尔定理 (Rolle’s Theorem) 推出来.
固定一个不与节点重合的 , 记:
在 个节点以及 处都为零, 一共有 个不同的零点. 反复使用罗尔定理, 它的 阶导数在某个 处为零. 又因为 的 阶导数为零, 是首项系数为 1 的 次多项式, 所以:解出 并代回, 就得到了余项公式. 恰好是节点时, 误差直接为零, 不需要做上面的除法.
如果能给高阶导数一个上界 , 就得到:
6.3 差分公式的余项也能一起换过去
等距节点下, 令 , 余项中的乘积变成:
所以:
检查下标时有一个简单办法: 插值公式最后一项的乘积到 , 余项的乘积到 . 余项多一个因子, 对应多一阶导数.
分段方法也有相应的局部余项. 当函数足够光滑时, 在 内:
其中 Hermite 使用的是精确端点导数. 第一式在二阶导数有界时给出 的误差上界, 第二式在四阶导数有界时给出 的误差上界. 这能解释为什么导数可靠、函数光滑时, 分段 Hermite 往往比分段线性更准确.
7. 写完公式以后, 用实验看看
7.1 先比较同一组数据
实验使用:
这里用大写 表示函数, 小写 表示余弦项的频率参数, 避免把它们混在一起. 三角函数使用弧度.
基准取 , . 使用 9 个等距节点, 包含两端点, 对应次数上限 . 再取 200 个等分区间的中点作为检验点:
没有直接用插值节点来检验, 因为所有方法都要求经过节点, 只看节点就很难发现区间内部的误差. 平均误差使用平均绝对误差 (Mean Absolute Error, MAE):
下表来自同一份 C++ 实验的实际输出, 数值按四位有效数字显示:
| 方法 | 平均绝对误差 |
|---|---|
| 范德蒙德 | |
| 拉格朗日 | |
| 一般牛顿 | |
| 差分牛顿 | |
| 分段线性 | |
| 分段 Hermite |

前四种方法的曲线几乎重合, 误差也非常接近. 这是唯一性定理在实验中的表现. 它们仍会因浮点计算步骤不同, 在更后面的小数位出现差别.
本例中全局多项式误差最小, 不能因此就说它永远最好. 分段 Hermite 的误差虽比分段线性小, 也要记得它额外使用了一阶导数:
7.2 一次只改变一个参数
如果把区间、频率、幅值一起改掉, 即使误差变大了, 也不好判断原因. 所以每组实验只改一个参数, 节点个数仍为 9, 检验点仍为 200.
| 变化 | 前四种方法的 MAE, 约值 | 分段线性 | 分段 Hermite |
|---|---|---|---|
| 基准 | |||
“前四种方法”这一列按报告精度合并展示, 并不表示它们每一位都完全相同.
区间变宽、节点个数不变时, 步长从 0.25 增大到 0.375. 两组区间实验的误差都变大了, 但它同时改变了取样范围, 不能把全部变化只归因于步长.
频率变大后, 函数起伏更快. 时, Hermite 的平均误差约为 , 小于全局多项式的 , 方法之间的排序发生了变化.

还有一处值得对照表格看: 加倍后, 前四种方法的平均误差几乎不变; 加倍后, 误差接近加倍. 两项的误差会叠加, 也可能部分抵消, 只把一项放大不能直接推断总误差会怎样变化.
7.3 加一点扰动, 节点更多反而可能更差
在每个节点的函数值上加入 内的均匀随机扰动, 每次六种方法使用同一组扰动. 随机种子为 20260929, 每种节点个数重复 20 次, 表格中的扰动 MAE 对 20 次实验取平均. Hermite 的解析导数保持不变.
| 方法 | 9 节点, 无扰动 | 9 节点, 扰动后 | 17 节点, 无扰动 | 17 节点, 扰动后 |
|---|---|---|---|---|
| 拉格朗日 | ||||
| 分段线性 | ||||
| 分段 Hermite |
表中用拉格朗日代表全局方法的变化趋势. 范德蒙德、一般牛顿和差分牛顿在本组实验中有相近结果, 完整数据仍分别保留在程序输出里.
无扰动时, 17 节点的全局插值非常准确. 加入扰动后, 平均误差反而从 9 节点时约 增大到约 . 更高的次数也带来了更明显的扰动放大.
这一点可以从拉格朗日公式看出来. 若节点值改变了 , 插值结果改变:
虽然 , 却不一定有 . 权重有正有负时, 它们的绝对值之和可能很大, 扰动就有机会被放大.
程序还统计了一个便于比较的量:
其中 是扰动后的插值结果. 全局方法的 平均值从 9 节点时约 2.822 增大到 17 节点时约 181.282. 这只是本组随机实验的观测量, 不等于一个严格的条件数, 分母也不是每次扰动样本的实际最大值.
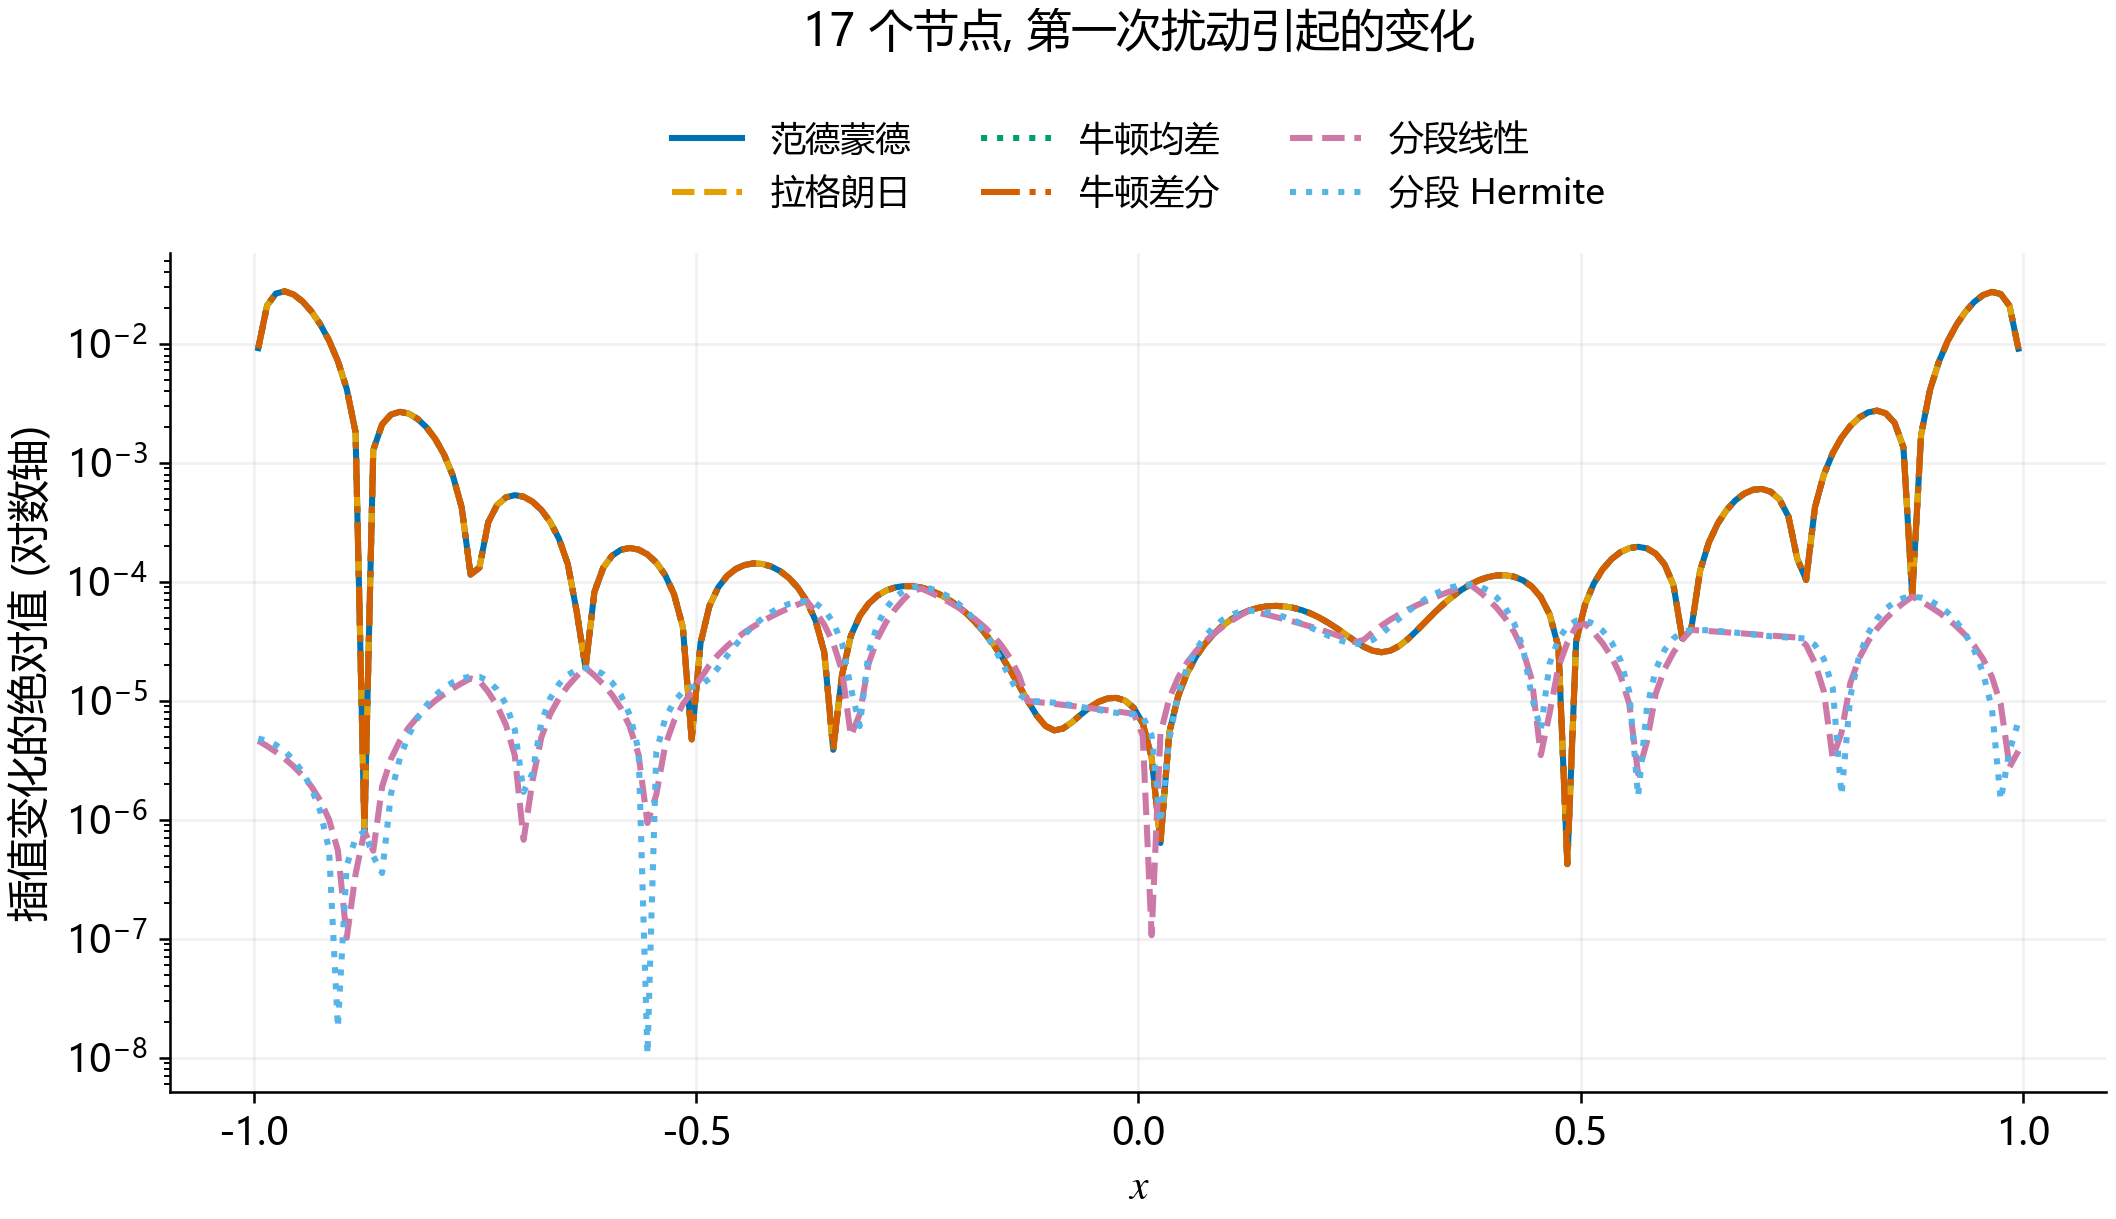
图里画的是第一次实验的响应, 表里是 20 次的平均结果. 前四条全局曲线几乎重合; 纵轴是对数轴, 用来观察不同数量级的变化.
分段线性的两个权重非负且和为 1, 因而区间内的函数值扰动不会超过输入扰动上界. 对本次实验的 Hermite, 由于导数没有变, 响应只有 . 在 时, 这两个权重也非负且和为 1, 所以同样有这个界. 如果连导数也扰动, 就要把导数项一起分析.
课件还介绍了龙格现象 (Runge’s Phenomenon): 对某些函数做高次等距插值, 节点增加后, 区间端部的振荡和误差反而更明显. 它和上面的扰动实验需要分开理解. 龙格现象可以在精确节点数据下发生; 这里的实验主要观察节点值的误差如何传播.
7.4 理论余项为零, 程序为什么还有小误差
最后对 使用 11 个等距节点, 在 上做插值. 11 节点对应次数上限 10, 而目标函数只有 6 次. 因此:
从唯一性也能得到同一个结论: 本来就满足全部节点条件, 而且次数不超过 10, 所以精确的插值多项式就是它.
用 301 个等分区间中点检验, 实际输出为:
| 方法 | 理论余项 | 平均绝对误差 |
|---|---|---|
| 拉格朗日 | 0 | |
| 牛顿 | 0 |
这些小误差来自浮点运算. 它们不能说明理论公式错了, 也不足以说明拉格朗日在所有问题上都比牛顿更准.
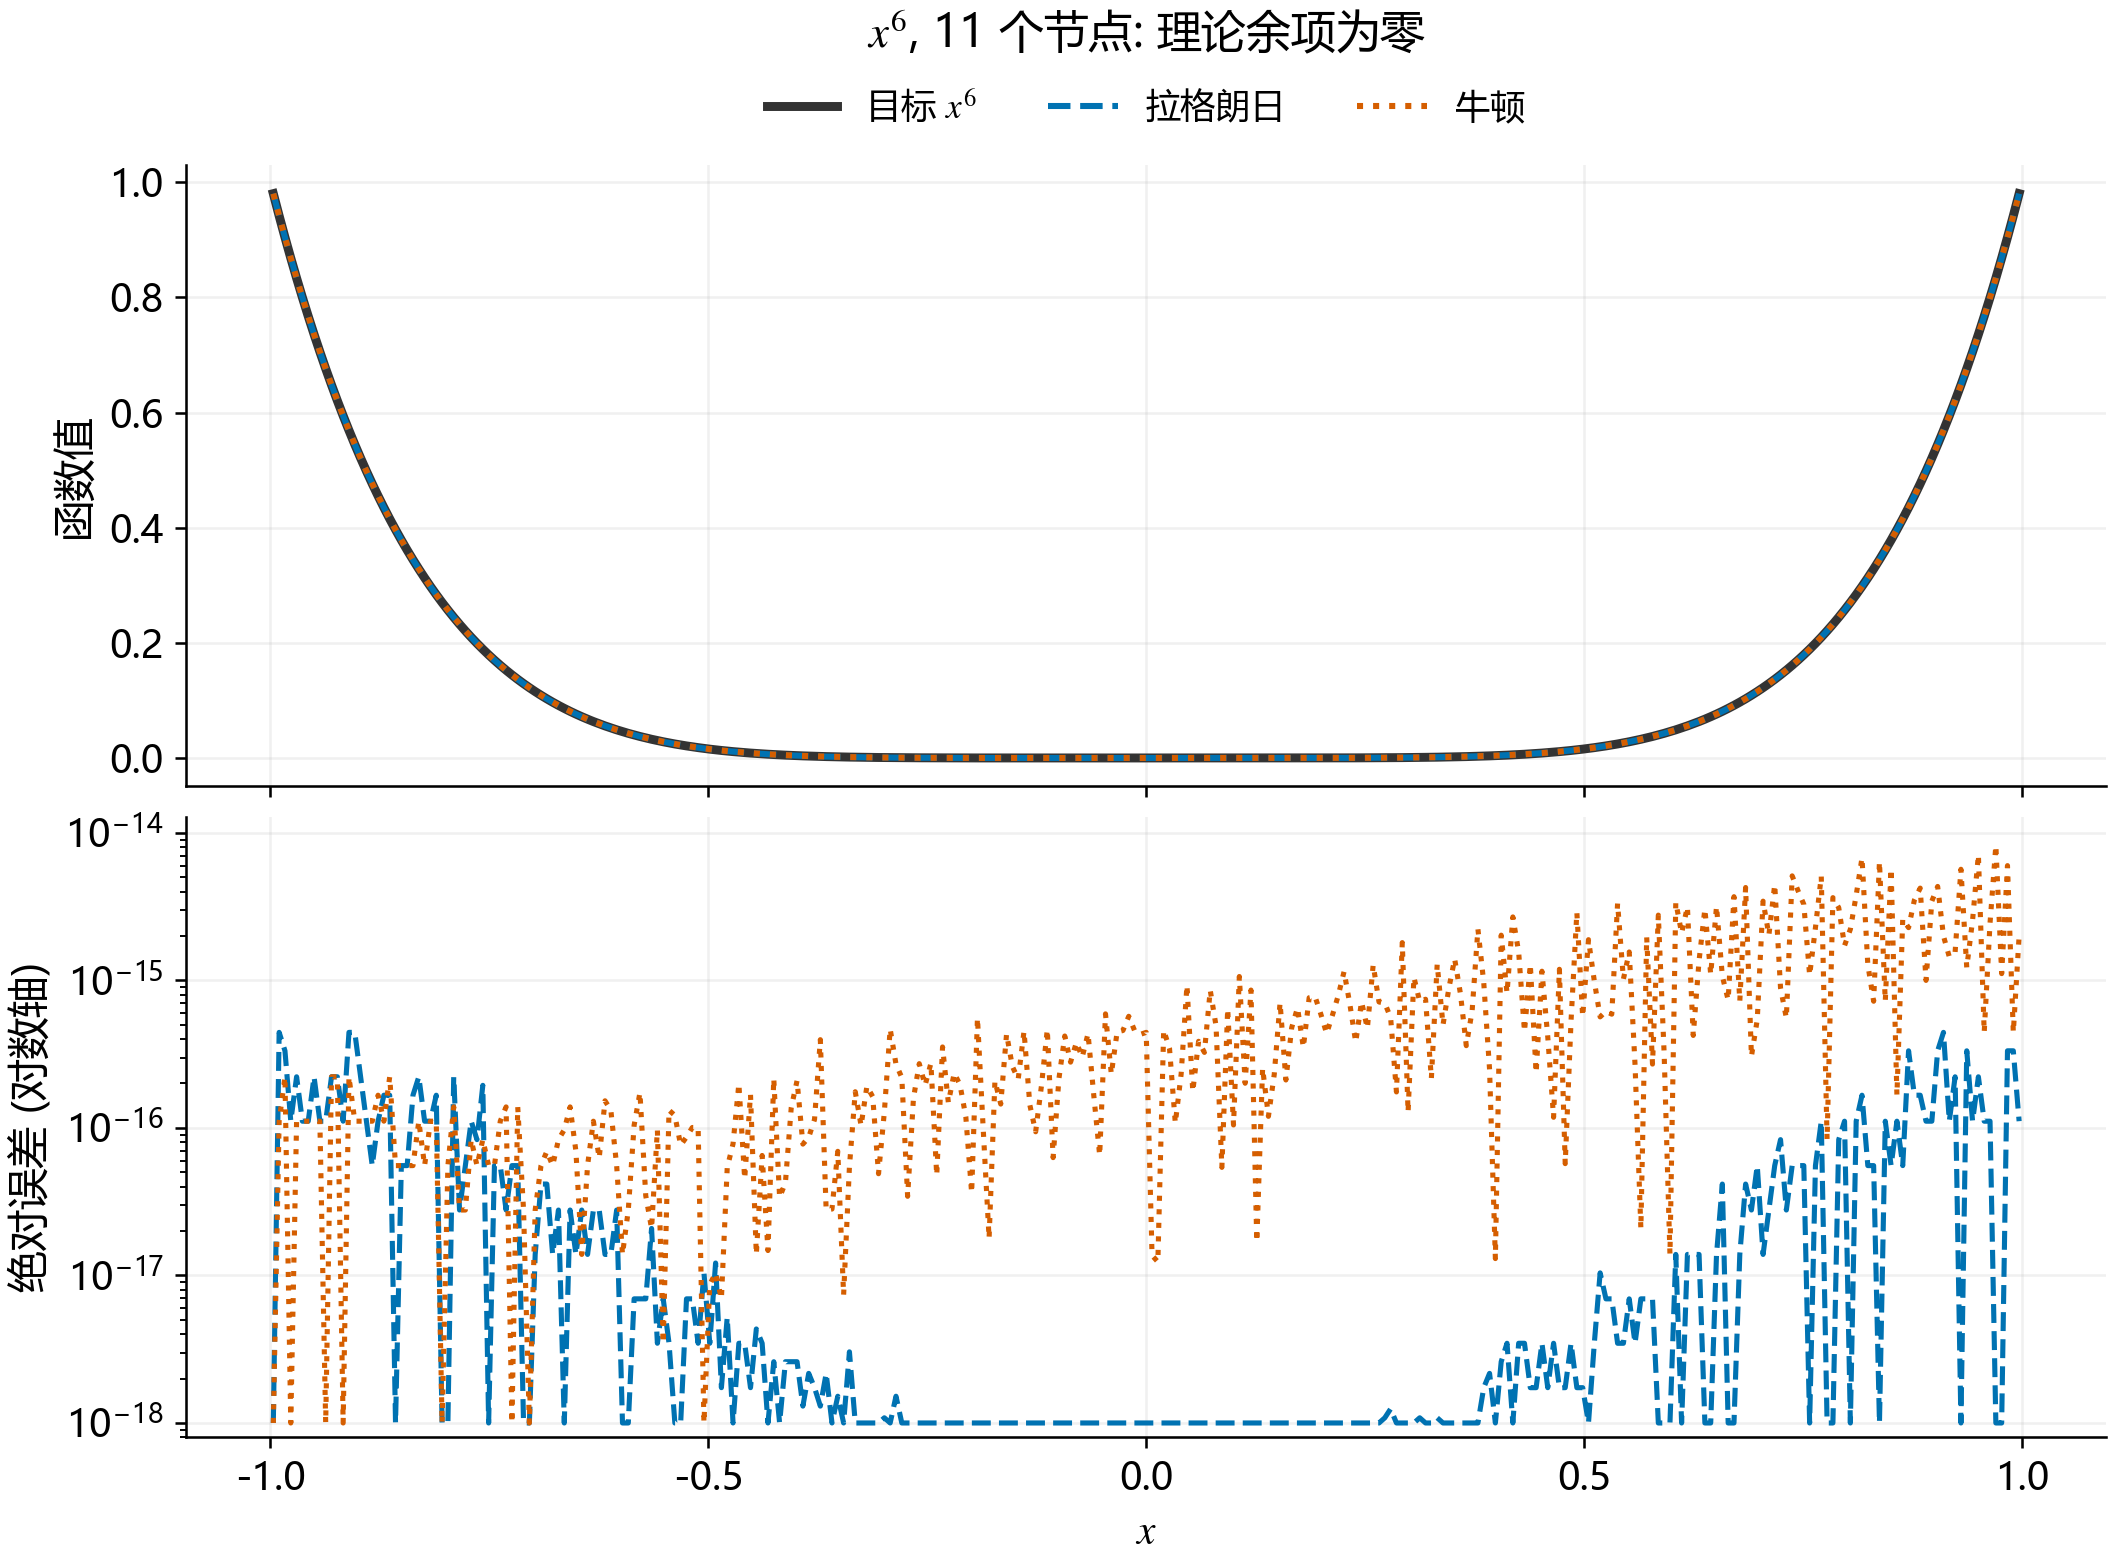
误差图使用对数轴. 为了显示, 小于 的值在图上按 画出; 表格和平均误差仍使用原始计算结果.
8. 自己跑一次
8.1 完整程序与输入
三份程序分别完成精度比较、扰动实验、幂函数余项实验, 每份都能独立编译, 不需要共用头文件. 算法用普通数组和循环实现, 最大节点个数为 100.
| 文件 | 用途 |
|---|---|
| task1_accuracy.cpp | 六种方法的精度与参数变化比较 |
| task2_perturbation.cpp | 节点函数值的随机扰动实验 |
| task3_remainder.cpp | 拉格朗日、牛顿的幂函数插值与余项实验 |
例如在装有 g++ 的环境中, 第一题可以这样运行:
g++ -std=c++11 -O2 task1_accuracy.cpp -o task1
./task1
输入:
-1 1 1 1 1 2 9 200依次对应 a b c d e f node_count test_count. 第二题使用相同的输入顺序; 把节点个数从 9 改为 17, 就能比较上面的两组扰动实验. 每次运行会覆盖当前目录中同名的 CSV, 想保留对比结果, 可以在不同文件夹里运行.
第三题的输入是 a b n m, 基准输入为:
-1 1 6 11这里 是幂次数, 是节点个数, 要满足 . 前两题源码中的 n 表示节点个数、m 表示检验点个数, 第三题采用的是题目自己的记号. 读程序时先看清输入含义, 不要把三个程序里的同名字母直接混用.
程序输出 CSV 数据, 四张图由这些数据单独绘制. 想检查一次运行是否正常, 可以先看基准行的 MAE 是否与本文接近, 再检查每个节点处的插值值是否与原值一致. 小数末尾可能随编译器和运行环境变化.
8.2 可以接着试的三个小问题
- 将三个点改为 . 为什么用三个节点, 最后得到的多项式仍然只有一次?
- 将节点改为 , 函数值仍取 . 用拉格朗日和一般牛顿求 的值, 再解释为什么不能继续套等距差分公式
- 对 使用两点三次 Hermite, 然后把导数项前的 删掉. 改变区间长度, 看端点导数条件在哪一步被破坏
再回到课件和教材时, 可以按“节点条件 → 构造多项式 → 误差”这条线读. 拉格朗日解决怎样直接构造, 牛顿解决怎样逐次添加, 分段方法减少每一段涉及的节点, 余项则说明它们与原函数之间还差多少.